TL;DR: Bland andra Köpings Bostads, Gislavedshus, Kindahus och Degerforsbyggen.
Vi har säkert alla hört talas om vilken fullständig katastrof Stockholms bostadskö är, och en snabb titt på den officiella webbplatsen bekräftar att "genomsnittliga kötiden under 2025 […] var 9 år". Det är en sådan bostadsbrist som egentligen skulle behöva ett nytt miljonprogram för att bygga sig ur, men vi vet alla att detta aldrig någonsin kommer hända under dagens politiska och ekonomiska klimat.
För att få bättre odds måste vi helt klart gå någon annanstans där efterfrågan är lägre och utbudet är större i förhållande. Så det är dags för dataanalys. Det som hjälper oss här är att vissa bostadsbolag tror på transparens och är snälla nog att låta oss bara se direkt hur många det är som söker var och en av lägenheterna (t.ex. "7"). Några exempel på detta som man också kan se i Bostadskvants demo är Karlstads Bostads, Gislavedshus och Solatum. I skrivande stund har de 2, 61 respektive 27 lediga lägenheter med noll sökande. Och det är bara tre transparenta bostadsbolag av totalt 75 just nu. En intresseanmälan är naturligtvis inte heller bindande. Det betyder bara att man blir inbjuden till visning om man är en av de sökande med längst kötid.
Men 75 är fortfarande bara runt en tredjedel av alla bostadsbolag som har något ledigt i mitt dataset (215 bostadsbolag totalt) och resten ger oss i princip ingenting att arbeta med. Därför måste vi bygga en modell. Min första idé var att titta på invånare/lägenhet, där högre alltså betyder mer konkurrens. Logiskt sett borde detta vara en bra indikator på balansen mellan utbud och efterfrågan. Men jag ville först testa detta mot bostadsbolag med synligt antal, för att se om det är en hyfsat pålitlig indikator. Och det visade sig att det aktuellt finns 27 lägenheter för 98k invånare i Lund, medan Köping har 37 för 19k. Invånare/lägenhet är alltså ~7x lägre i Köping. Och som förväntat ligger den historiska medianen för antalet sökande för annonser, som den såg ut på sista ansökningsdagen (medianantalet sökande), på 59 respektive 1. Några andra bostadsbolag som har väldigt lågt medianantal sökande är Gislavedshus (0), Kindahus (1) och Degerforsbyggen (1).
Tyvärr har jag ingen data för kötider för folk som faktiskt fick skriva kontrakt i slutändan. Det verkar som att det är mer hemligt, där vi får nöja oss med sammanfattningar direkt från källan, om ens det. Men jag tror det är rimligt att säga att man utan kötid inte kommer kunna skriva under i Lund inom snar framtid, medan man kan skriva under i Köping direkt.
Från dessa två datapunkter och deras relation skulle man kunna tro att det inte ens spelar någon roll exakt var man flyttar, så länge befolkningen är liten. Det verkar dock inte vara så enkelt. Ta till exempel Byggebo, som för tillfället har 23 lägenheter i Oskarshamn, en stad med ~19k invånare, så hyfsat jämförbar med Köping, men ändå är medianantalet sökande 21 istället för 1.
Men låt oss försöka att direkt kvantifiera träffsäkerheten hos befolkning och invånare/lägenhet som prediktorer för hur lätt det är att få en lägenhet, istället för att bara plocka russinen ur kakan åt ena eller andra hållet. Mitt sätt att göra det här var att iterera över alla par av orter och kolla i hur många % av jämförelserna varje mått kunde förutsäga vilken ort som skulle ha högre medianantal sökande. 50 % skulle alltså vara samma sak som att gissa och 100 % skulle vara "perfekt", åtminstone när det kommer till vårt stickprov på 150 orter med några veckors annonser. Efter att ha kört koden kan vi se att befolkning stämmer i 66,4 % av fallen och invånare/lägenhet stämmer i 79,8 % av fallen. Det betyder naturligtvis att det ändå är fel en av fem gånger. Och jag skulle kunna visa en tredje jämförelse som demonstrerar även detta fall, men jag tror att man fattar poängen vid det här läget.
Medianantalet sökande är alltså referensen för att bedöma hur lätt det är att få en lägenhet, men invånare/lägenhet fungerar fortfarande som reserv. Jag märkte dock snabbt att det är otroligt irriterande att ha två "inkompatibla" mått som mäter samma sak. Så jag visste att jag skulle behöva hitta ett sätt att ta fram ett ungefärligt antal sökande från kvoten. Algoritmen som jag skapade i slutändan fungerade så att den i princip plottar alla transparenta lägenheter med invånare/lägenhet för orten på x-axeln och antal sökande på sista dagen på y-axeln, för att därefter dra en regressionslinje genom alla punkter på de mest lämpliga logaritmiska skalorna (se bild nedan) med tillplattade kanter.
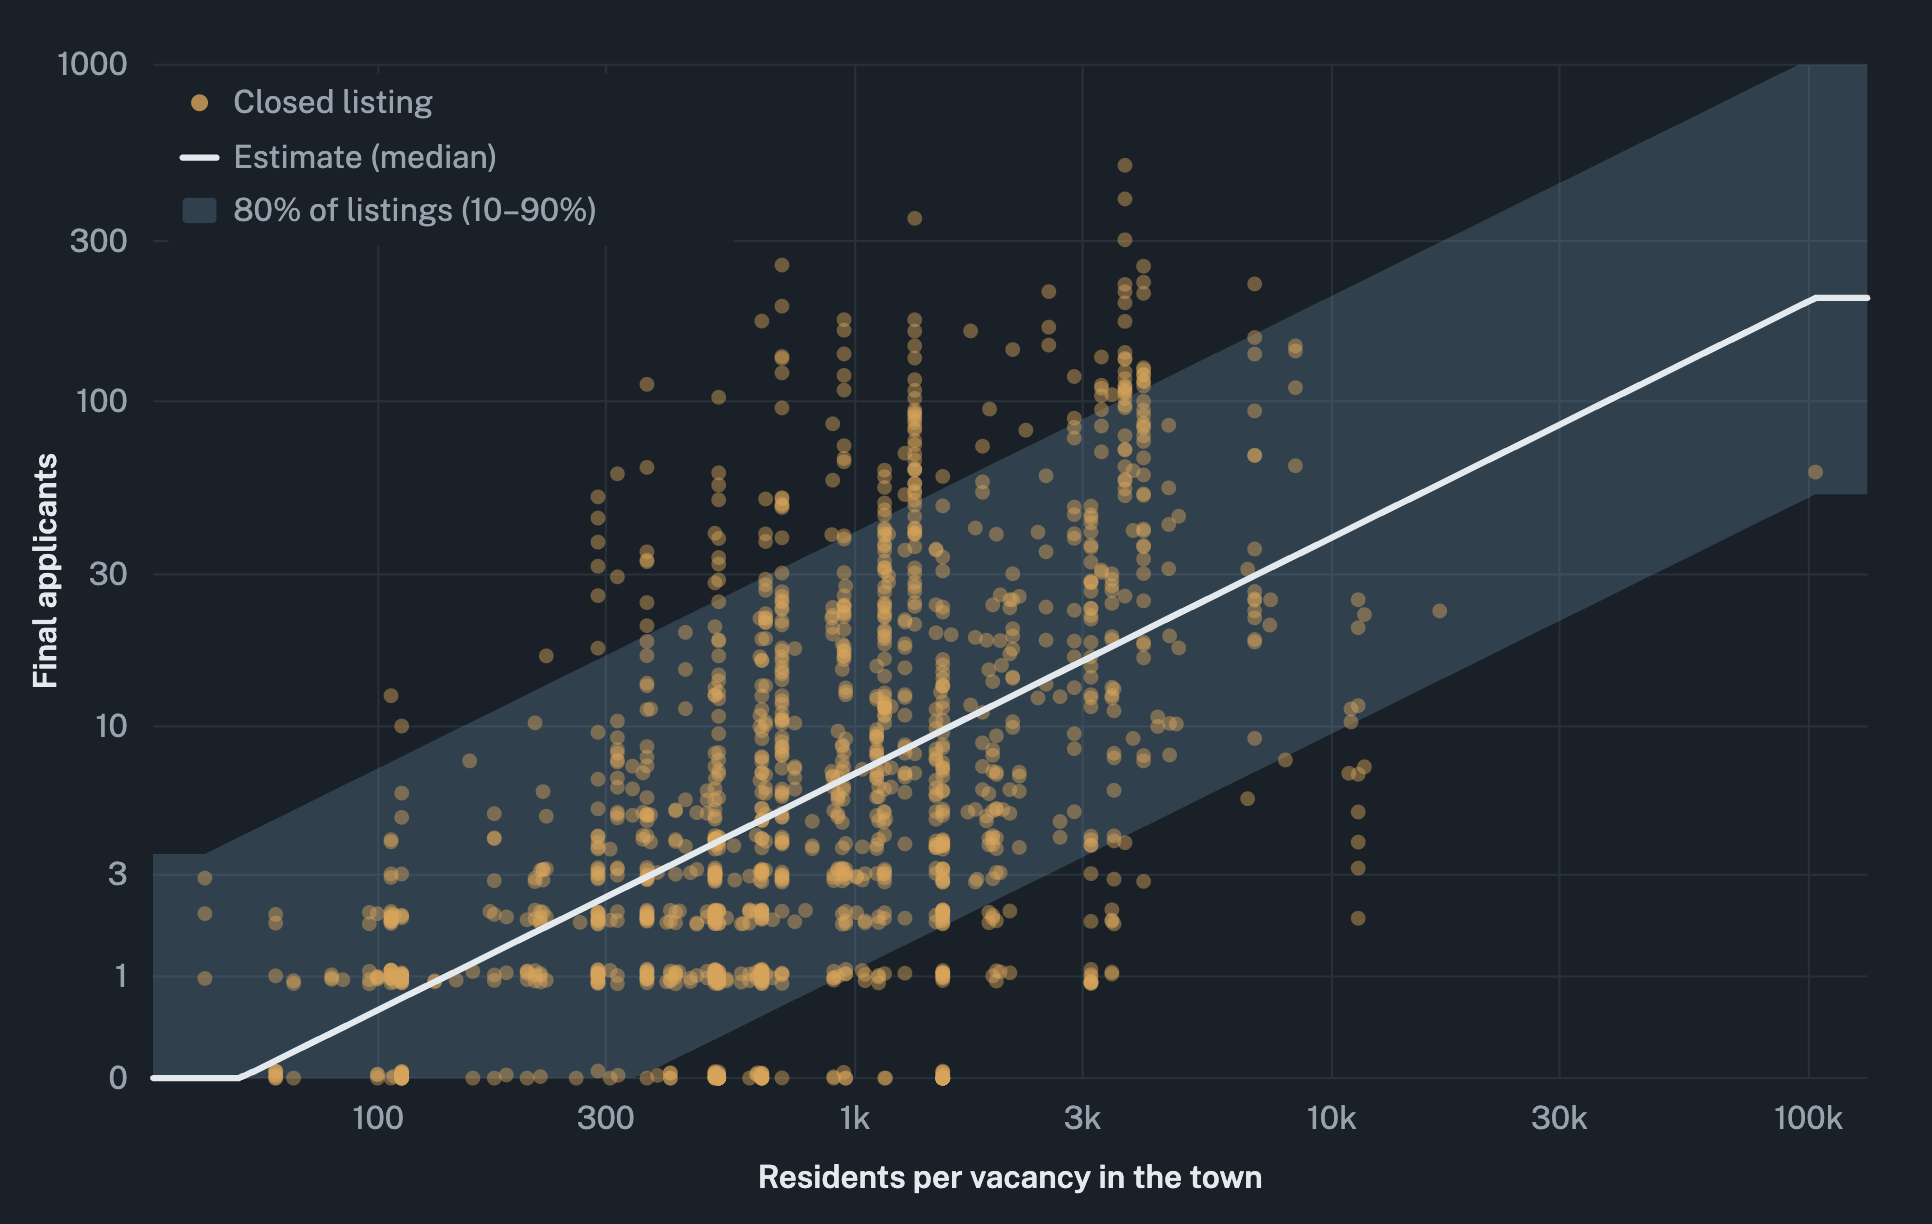
För att få något slags spann har jag flyttat linjen uppåt och nedåt så att de högsta och lägsta 10 % av värdena hamnar utanför spannet. Men jag måste ärligt säga att det är så pass brett att jag knappt kollar på det i praktiken. Ta till exempel Enköping, med invånare/lägenhet på 584. Detta ger alla lägenheter där en uppskattad median på 4, men med ett spann från 0 hela vägen till 27. Det är förstås lite nedslående, eftersom ju bredare spannet är desto mindre meningsfull kommer medianen att vara för enskilda lägenheter. För att inte tala om att det finns väldigt få annonser över ~5k invånare/lägenhet. Så det blir ganska tveksam extrapolering utöver det. Men i slutändan är all information redan ganska approximativ och jag tror att det fortfarande är mycket bättre än att inte ha något alls. Jag har också försökt att inkludera fakta om själva lägenheten, men hittills har jag inte hittat någon bra prediktor för antal sökande inom samma ort. Så det behövs definitivt mer forskning där.
Detta täcker alltså hur uppskattat antal sökande fungerar (t.ex. "~7 uppsk."), men det finns också ett förväntat antal sökande (t.ex. "1 → 3"). Varför behövs detta nu? Bara antal sökande är logiskt sett inte riktigt jämförbart eftersom alla börjar på noll och sedan växer i olika takt, beroende på hur hög efterfrågan är. Men om man filtrerar efter något i stil med "färre än 3 sökande" säger intuitionen att detta är det slutgiltiga resultatet som inte ändras längre. En lägenhet som har legat ute i 2 timmar är helt enkelt inte jämförbar med en som har legat ute en vecka i det här sammanhanget. Jag har redan gett en ledtråd till lösningen på detta när jag sade "växer i olika takt", eftersom det är exakt så jag valde att fixa problemet. Kolla på historiska tillväxttakter för antal sökande hos alla historiska lägenheter över dagarna, ta medianen, och återigen extrapolera tveksamt för att förutse hur många det historiskt sett borde bli på sista anmälningsdagen.
En sak som jag har valt att inte ta hänsyn till, men ändå vill nämna, är måttet "Högsta poäng" som 21 bostadsbolag publicerar. Detta säger naturligtvis hur mycket kötid man skulle behöva för att vara först i kön, alltså i teorin ännu mer exakt än bara antal sökande. Men personligen anser jag att det inte är tillräckligt med data för meningsfull analys.
Avslutningsvis: Om man är beredd att kolla på olika ställen finns det absolut bostadsköer där man konkurrerar med nästan ingen. Som de nämnda Köpings Bostads, Gislavedshus, Kindahus och Degerforsbyggen. Använd gärna också Bostadskvant för att hitta fler av dem, genom att filtrera efter lägenheter med lågt antal sökande, tillsammans med andra krav du har, som utrustning, policies eller närhet.